Autor
TL;DR
O treinamento de um modelo de ML às vezes pode ser complicado de configurar e replicar:
- Isso pode ser feito usando algum código hospedado em um notebook em uma VM que o senhor precisa iniciar manualmente e desligar quando terminar
- Talvez o senhor tenha que carregar um dataset de treinamento toda vez que quiser treiná-lo novamente
- O senhor precisa mergulhar fundo em seu código quando quiser alterar um único parâmetro
- etc.
Neste artigo, veremos como automatizamos o processo de treinamento dos classificadores de texto da FastAI, usando o Google Cloud AI Platform.
Em um segundo artigo, veremos como conseguimos implantar esses modelos com o AI Platform e o TorchServe.
Para quem?
Se estiver trabalhando em um projeto que exija o treinamento de modelos de ML várias vezes e estiver cansado de ter que executar os treinamentos manualmente, o senhor veio ao lugar certo.
Se estiver cansado de gerenciar VMs para seu treinamento e quiser que seu tempo seja dedicado a algo mais interessante, como ler artigos do Medium, o senhor também veio ao lugar certo!
Este artigo é dedicado àqueles que querem saber como podem ganhar tempo e recursos usando o AI Platform para o treinamento de seus modelos de ML. Neste artigo, veremos como aplicamos isso a um projeto em que trabalhamos, usando o FastAI.
Este artigo é dedicado àqueles que querem saber como podem ganhar tempo e recursos usando o AI Platform para o treinamento de seus modelos de ML. Neste artigo, veremos como aplicamos isso a um projeto em que trabalhamos, usando o FastAI.
Pré-requisitos se o senhor quiser reproduzir o que fizemos
O AI Platform faz parte do pacote Google Cloud Platform, assim como os outros serviços que usamos para automatizar nosso pipeline de treinamento. Aqui estão os serviços do GCP que usamos:
O Google Cloud SDK, o Docker e o Nvidia-docker precisam ser instalados e configurados no computador em que a imagem do Docker é criada. O objetivo da instalação do Nvidia-docker é poder executar a imagem do Docker criada diretamente na GPU da máquina (se houver uma), para garantir que não haja erros no código e que o treinamento seja executado conforme o esperado ao ser executado na AI Platform.
Como veremos mais adiante no artigo, a imagem do Docker foi criada a partir da imagem do Docker Nvidia-Cuda, portanto, os drivers Nvidia necessários são instalados automaticamente durante a criação da imagem.
Contexto
Neste artigo, veremos como automatizamos o treinamento de um classificador de texto feito com o FastAI, uma biblioteca que permite aos usuários criar modelos avançados graças ao método ULM FiT.
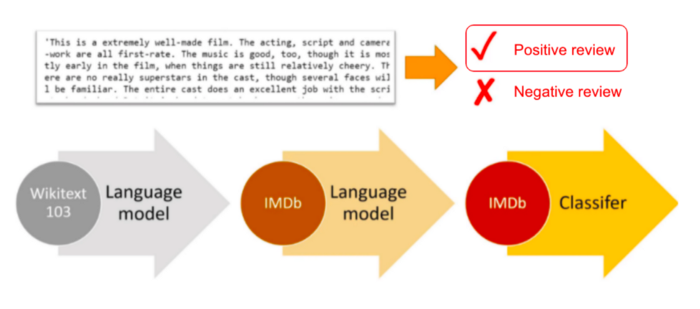
Já o apresentamos em Outro artigo do Medium, Por isso, convido o senhor a dar uma olhada se quiser saber mais sobre o assunto.
Como o que veremos neste artigo será aplicável a qualquer estrutura, o senhor não precisa estar familiarizado com o FastAI para continuar lendo. Tudo o que o senhor precisa saber é que usamos um modelo pré-treinado para treinar nosso classificador de texto, além de um dataset com rótulo de treinamento.
Como configuramos o treinamento com a AIPlatform
Para automatizar o treinamento de modelos com o AI Platform, o senhor precisa especificar qual código deve ser executado em qual ambiente quando o comando de treinamento for chamado. A melhor maneira de fazer isso é criar uma imagem Docker que contenha todo o código de treinamento e seu ambiente, de modo que o AI Platform só precise criar um contêiner a partir dessa imagem sempre que o senhor pedir para treinar um modelo. Nesta parte, veremos como fizemos isso.
Armazene todos os arquivos necessários em um bucket do GCS
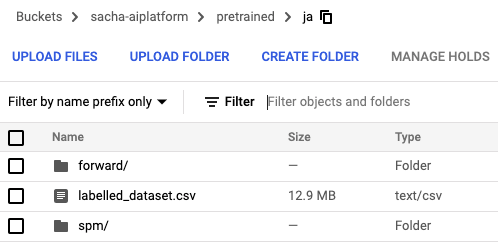
Antes de criar a imagem do Docker que contém nosso treinamento, tivemos que pensar nos arquivos que são usados durante o treinamento de um modelo de classificador de texto da FastAI. Portanto, decidimos armazenar todos os arquivos necessários para o treinamento em um bucket do GCS, separados em pastas para cada idioma, com um nome específico dado a cada arquivo.
Em seguida, implementamos em nosso código de treinamento (como veremos abaixo) um método para recuperar esses arquivos necessários do GCS, especificando apenas o idioma de destino como argumento.
Escrever o código de treinamento
Depois de fazer o upload dos arquivos necessários no GCS, criamos um arquivo repo que contém o código para o treinamento de nossos modelos, destinado a ser armazenado em uma imagem do Docker posteriormente.
Como o senhor pode ver no repositório vinculado, dividimos o código do treinamento em arquivos separados para lidar adequadamente com todo o pipeline de treinamento.
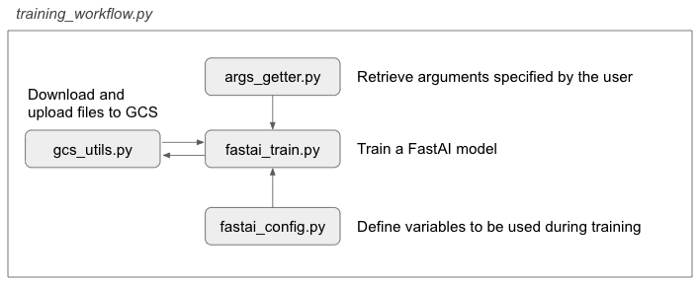
Definimos um arquivo que executa todo o fluxo de trabalho de treinamento da seguinte forma:
fastai_train.py é o único arquivo que usa diretamente os métodos da FastAI, portanto, se alguém quiser implantar outra estrutura em seu treinamento, basta modificar esse arquivo (e o conteúdo do arquivo de configuração, é claro).
A próxima etapa foi criar uma imagem do docker que conterá tudo o que é necessário para que o treinamento seja executado corretamente.
Criar o Dockerfile
Depois de preparar o código de treinamento, um Dockerfile precisava ser criado e enviado para o Google Container Registry, para permitir que a AI Platform o recuperasse e executasse no ambiente certo.
Como o treinamento do nosso modelo precisava ser executado na GPU, importamos a imagem do Nvidia-cuda Docker para criar a nossa própria imagem, de modo que todos os drivers necessários já estivessem instalados.
# Dockerfile
DE nvidia/cuda:10.2-devel

EXECUTAR apt-get update && apt-get install -y --no-install-recommends
    wget
    essencial para a compilação

EXECUTAR apt-get update && apt-get install -y --no-install-recommends
    python3-dev
    python3-setuptools
    python3-pip

EXECUTAR pip3 install pip==20.3.1

WORKDIR /root

# Crie diretórios para conter o código e o modelo baixado do GCS
EXECUTAR mkdir /root/trainer

RUN mkdir /root/models

# Copiar requisitos
COPY requirements.txt /root/requirements.txt

# Instalar o pytorch
RUN pip3 install torch==1.8.0

# Instalar os requisitos
RUN pip3 install -r requirements.txt

# Instala o sdk do google cloud, principalmente para usar o gsutil para exportar o modelo.
EXECUTAR wget -nv
    https://dl.google.com/dl/cloudsdk/release/google-cloud-sdk.tar.gz &&
    mkdir /root/tools &&
    tar xvzf google-cloud-sdk.tar.gz -C /root/tools &&
    rm google-cloud-sdk.tar.gz &&
    /root/tools/google-cloud-sdk/install.sh --usage-reporting=false
        --path-update=false --bash-completion=false
        --disable-installation-options &&
    rm -rf /root/.config/* &&
    ln -s /root/.config /config &&
    # Remova o diretório de backup que gcloud cria
    rm -rf /root/tools/google-cloud-sdk/.install/.backup

# Copiar arquivos
COPY trainer/fastai_train.py /root/trainer/fastai_train.py

COPY trainer/fastai_config.py /root/trainer/fastai_config.py

COPY trainer/args_getter.py /root/trainer/args_getter.py

COPY trainer/gcs_utils.py /root/trainer/gcs_utils.py

COPY trainer/training_workflow.py /root/trainer/training_workflow.py

# Configuração do caminho
ENV PATH $PATH:/root/tools/google-cloud-sdk/bin

# Certifique-se de que o gsutil usará a conta de serviço padrão
RUN echo '[GoogleCompute]nservice_account = default' > /etc/boto.cfg

# Autentique-se no GCP
CMD gcloud auth login

# Configura o ponto de entrada para invocar o treinador.
ENTRYPOINT ["python3", "trainer/training_workflow.py"].
Como o senhor pode ver acima, o Dockerfile executa as seguintes etapas para criar a imagem:
Criar a imagem e enviá-la para o GCR
Depois de criar o Dockerfile, foi necessário criar a imagem para enviá-la ao GCR. Conforme especificado no repositório, várias variáveis locais precisavam ser definidas, como a variável IMAGE_URI no GCR, o REGIÃO nossas operações, etc.
A imagem foi criada com a execução deste comando:
docker build -f Dockerfile -t $IMAGE_URI ./
Antes de enviá-la para o GCR, queríamos garantir que tudo funcionaria bem ao chamar o treinamento, portanto, como nossa VM tinha uma GPU disponível, executamos a imagem antes de enviá-la para ver o que acontecia:
docker run --runtime=nvidia $IMAGE_URI --epochs 1 --bucket-name $BUCKET_NAME
Essa etapa não é necessária, mas pode economizar muito tempo, pois o senhor verá diretamente se há erros no seu código.
Finalmente, enviamos o contêiner para o GCR executando o seguinte comando, $IMAGE_URI sendo a variável referente ao URI onde a imagem está armazenada no GCR:
docker push $IMAGE_URI
Executar e acompanhar o trabalho
Depois de seguir as etapas anteriores, o treinamento do modelo estava pronto para ser chamado usando um simples comando no terminal. O Google Cloud SDK só precisava ser ativado e as variáveis locais definidas:
gcloud ai-platform jobs submit training $JOB_NAME
--scale-tier BASIC_GPU
--region $REGION
--master-image-uri $IMAGE_URI
--
--lang=fr
--epochs=10
--bucket-name=$BUCKET_NAME
--model-dir=$MODEL_DIR
Esse comando solicita que a AI Platform recupere o contêiner no GCR usando seu IMAGE_URI e, em seguida, execute o treinamento na GPU de uma máquina hospedada na região REGION.
Especificamos vários argumentos aqui, como o idioma do treinamento, o número de épocas, o nome do bucket para carregar e baixar arquivos no GCS e o diretório onde armazenar o modelo treinado. Esses são os argumentos que são recuperados pelo arquivo args_getter.py
Depois de executar o comando, o treinamento foi iniciado e um trabalho foi criado no console do AI Platform, o que nos permitiu acompanhar a evolução do treinamento e verificar os logs da máquina que o executava.
Muitas informações podem ser acessadas quando se examina o trabalho no console do AI Platform
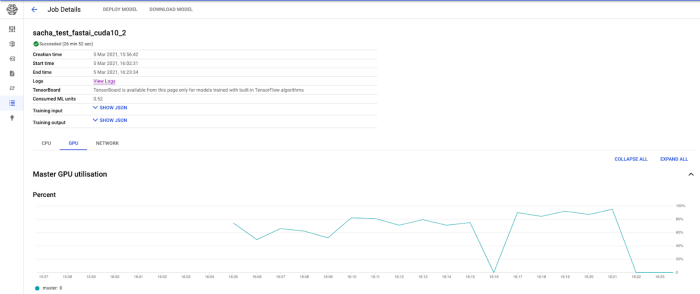
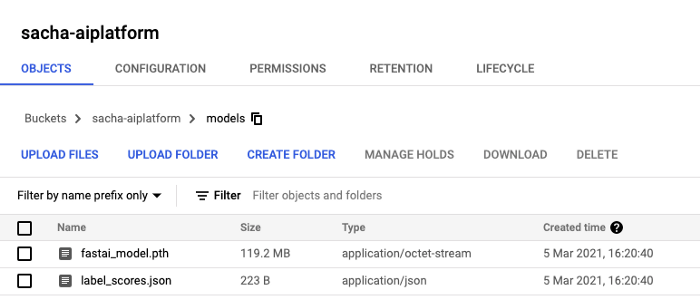
Quando o trabalho é concluído, o modelo treinado é salvo em um bucket do GCS como um arquivo .pth junto com um arquivo .json que contém seu desempenho.
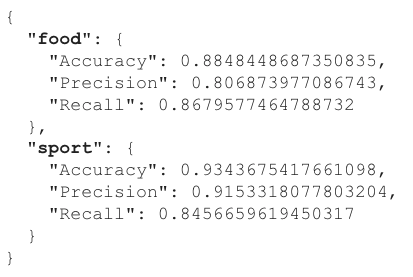
Decidimos considerar os resultados dos rótulos separadamente, como se tivéssemos um classificador binário para cada rótulo possível.
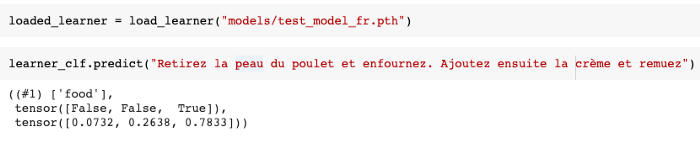
Como usamos o FastAI, o arquivo de modelo pode ser carregado diretamente em qualquer ambiente chamando o método load_learner() do FastAI.
Principais conclusões
Automatizar o treinamento de nossos modelos usando o AI Platform nos permitiu economizar muito tempo e nos fez considerar vários aspectos do treinamento de nossos modelos para colocá-los em produção com eficiência.
Aqui estão algumas conclusões que obtivemos com isso:
O que vem a seguir?
Agora que já explicamos como automatizamos o treinamento do nosso modelo, podemos mostrar aos senhores como conseguimos torná-lo facilmente chamável para classificar arquivos sob demanda.
Fique atento à segunda parte deste artigo, que explicará tudo o que o senhor precisa saber para implantar seus classificadores treinados usando o AI Platform e o TorchServe!
Obrigado pela leitura!
Esperamos que o senhor tenha aprendido algo hoje e que isso seja útil para seus futuros projetos de ML. Fique à vontade para entrar em contato conosco se tiver alguma dúvida ou comentário sobre este tópico.