
Einführung
Künstliche Intelligenz entwickelt sich rasch zu einer alltäglichen Selbstverständlichkeit. Jedes Unternehmen hat mittlerweile Zugang zu immer leistungsfähigeren KI-Modellen, die sich in außergewöhnlichem Tempo weiterentwickeln. Ein Wettbewerbsvorteil wird sich nicht aus den Modellen selbst ergeben, sondern von der Qualität der Unternehmensinformationen, auf die sie zugreifen können.
Enterprise Intelligence geht über das data-Konzept hinaus. Erst die Kombination aus geschäftlicher Bedeutung, Governance, Zusammenhängen, Richtlinien und institutionellem Wissen ermöglicht es der KI, zu verstehen, wie ein Unternehmen tatsächlich funktioniert. Ohne diese Kombination haben selbst die leistungsfähigsten KI-Modelle Schwierigkeiten, vertrauenswürdige, nachvollziehbare und umsetzbare Ergebnisse zu liefern.
Die Herausforderung besteht nicht darin, Business Intelligence von Grund auf neu zu entwickeln. Es geht vielmehr darum, die Zusammenführung fragmentierter Geschäftswissen in einer geregelten Ebene, und diese entsprechend den Veränderungen im Geschäftsbetrieb kontinuierlich weiterzuentwickeln. Genau an dieser Stelle geraten viele KI-Transformationsprojekte ins Stocken. Nehmen wir als Beispiel eine Bank, die den Begriff “risikoreicher Kunde” definiert. Die Compliance-Abteilung meldet diese Kunden wegen verdächtiger Aktivitäten, die Kreditabteilung wegen eines wahrscheinlichen Zahlungsausfalls und die Betrugsbekämpfung wegen ungewöhnlicher Transaktionen. Jedes Team hat nach seinen eigenen Regeln Recht, doch die Definitionen stimmen nicht überein – und genau diese Lücke schließt die Governance, indem sie jedem System und jedem KI-Agenten eine einheitliche Antwort liefert.
Dieser Artikel stellt einen Leitfaden für KI im Unternehmenskontext vor. Starburst veranschaulicht, wie Unternehmen vertrauenswürdige Unternehmensintelligenz über verteilte data- und metadata-Systeme hinweg schaffen. Artefact veranschaulicht das Betriebsmodell, das es ermöglicht, diese Intelligenz kontinuierlich zu ermitteln, zu zertifizieren, wiederzuverwenden und zu verbessern. Zusammen bilden sie die technologische Grundlage und das Organisationsmodell, die erforderlich sind, um KI im Unternehmensmaßstab zu operationalisieren.
Warum dialogorientierte data-Agenten nach wiederholten erfolgreichen Pilotprojekten nicht skalierbar sind
Die meisten Organisationen haben bewiesen, dass konversationelle KI können funktionieren. Sie entwickeln beeindruckende Pilotprojekte, demonstrieren einen echten geschäftlichen Nutzen und sorgen unternehmensweit für Begeisterung. Allerdings gelingt es nur wenigen, diese Erfolge auf unternehmensweite Ebene auszuweiten.
Die Herausforderung liegt in der Einsatzbereitschaft im Unternehmensumfeld. Bevor dialogorientierte data-Agenten zuverlässig und in großem Maßstab eingesetzt werden können, müssen Unternehmen drei grundlegende Fragen beantworten:
- Wer legt den geschäftlichen Kontext fest, in dem die KI eingesetzt werden soll?
- Wie können wir sicherstellen, dass KI-Empfehlungen zuverlässig und nachvollziehbar sind und mit der Rechenschaftspflicht der Organisation in Einklang stehen?
- Wie lernt das System kontinuierlich dazu und verbessert sich im Zuge der geschäftlichen Entwicklung?
Die Enterprise-Intelligence-Ebene: Die data foundations-Lösungen, über die Sie bereits verfügen, sind Ihre wertvollsten KI-Ressourcen
Künstliche Intelligenz kann lediglich zuverlässige Geschäftsergebnisse wenn drei Dinge nacheinander eintreten: Das Unternehmen data muss erreichbar sein, die geschäftlichen Zusammenhänge müssen strukturiert sein und vertrauenswürdige Informationen müssen überall dort aktiviert werden, wo Entscheidungen getroffen werden.
Die Enterprise Context Layer schafft diese Grundlage durch ein einfaches Ausführungsmodell:
Verbinden. Enterprise data und metadata sind bereits in operativen Systemen, auf cloud-Plattformen, in data-Lakes, in Katalogen, in semantischen Modellen, in BI-Tools sowie in der Dokumentation vorhanden.
Anstatt von Unternehmen zu verlangen, diese Ressourcen zu zentralisieren, verbindet Starburst sowohl data als auch metadata miteinander, sodass KI-Initiativen sofort gestartet werden können, ohne auf Migrations- oder Konsolidierungsprojekte warten zu müssen. Unternehmen nutzen zunächst die Daten, über die sie bereits verfügen.
Organisieren. Vernetztes data wird zu wiederverwendbarer Unternehmensintelligenz. Die Enterprise Context Layer organisiert das verbundene data zu KI-fähigen data-Produkten, die auf die Geschäftsabläufe abgestimmt sind – Kunde, Produkt, Richtlinie, Konto, Risiko, Lieferant und andere zentrale Geschäftseinheiten.
Jedes data-Produkt vereint vier Elemente:
- Bewährt data
- Geschäftliche Bedeutung
- Geschäftslogik
- Integrierte Unternehmensführung
Zusammen bilden diese wiederverwendbare Einheiten von Unternehmensintelligenz, die in Analysen, Anwendungen und KI gemeinsam genutzt werden können. Anstatt den geschäftlichen Kontext für jedes Dashboard oder jeden Agenten neu zu erstellen, erstellen Unternehmen ihn einmalig und nutzen ihn dann überall wieder.
Aktivieren. KI-fähige data-Produkte bilden die gemeinsame Wissensgrundlage für Dashboards, Anwendungen, AIDA und zugelassene KI-Agenten. Da jedes data-Produkt bereits vertrauenswürdige geschäftliche Bedeutungen, Beziehungen, Governance-Regeln und wiederverwendbare Geschäftslogik enthält, kann die KI auf der Grundlage von Unternehmenswissen statt auf der Grundlage von Rohdaten aus data Schlussfolgerungen ziehen.
Mit der kontinuierlichen Verbesserung der KI-Modelle steigt auch der Wert der Enterprise Context Layer. Intelligentere Modelle steigern den Wert verlässlicher Unternehmensinformationen.
Der Multiplikator lautet: Modell × Unternehmensintelligenz
Vernetzen. Organisieren. Aktivieren.
Schafft die technologische Grundlage für KI im Unternehmensbereich.
Um diese Grundlage in die Praxis umzusetzen, ist eine weitere Fähigkeit erforderlich: Kontinuierliche Verbesserung.
Im Finanzdienstleistungssektor ist diese Grundlage näher, als den meisten Organisationen bewusst ist. Zwar investierten Finanzinstitute ursprünglich in Governance-Maßnahmen, um regulatorische Vorgaben zu erfüllen, doch diese zwangsläufigen Bemühungen haben die zentralen Bausteine einer Kontext-Ebene hervorgebracht:
- Data Stewards die über ein detailliertes Verständnis der betriebswirtschaftlichen Definitionen auf Feldebene verfügen
- Data-Domänen gekennzeichnet durch gefestigte Eigentumsverhältnisse und eine klare Abstammungslinie
- Fachglossare für die Wirtschaft unter behördlicher Aufsicht entwickelt und bereits mit der Logik ausgestattet, die ein KI-Assistent benötigt, um vertrauenswürdig zu funktionieren
Der Einsatz von dialogorientierten Data-Agenten im Finanzdienstleistungssektor stellt keine völlig neue Transformation dar. Es handelt sich vielmehr um eine natürliche Entwicklung der bereits bestehenden data governance-Programme, diesmal jedoch nicht nur zur Erfüllung gesetzlicher Anforderungen.
Beispiel – Wer ist der Kunde?
Betrachten Sie eine einfache Frage in einem großen Bankhaus: Wer ist der Kunde? Das klingt einfach, stellt jedoch eine der komplexesten Herausforderungen im Bereich data im Finanzdienstleistungssektor dar.
Die Antwort hängt davon ab, wer diese Frage stellt. Im Privatkundengeschäft wird ein Kunde als Kontoinhaber definiert. Im Firmenkundengeschäft wird eine juristische Person oder ein Konzern als Kunde betrachtet. In der Vermögensverwaltung wird ein Haushalt als Kunde definiert. AML- und KYC-Teams definieren einen Kunden als eine Person, die einer Risikobewertung unterzogen wurde und deren Status anhand von Überprüfungen und Beobachtungslisten ermittelt wird. Das Marketing betrachtet einen Kunden als ein ansprechbares Profil, das auf der Grundlage von Verhaltens- und Transaktionssignalen erstellt wird.
Stellen Sie nun jedem Team dieselbe Frage: Wie viele aktive Kunden haben wir? Jede gibt eine andere Zahl zurück, da jede eine andere, wenn auch gültige, geschäftliche Definition verwendet. Ohne geschäftlichen Kontext lassen sich diese Antworten nicht miteinander in Einklang bringen. Ein „Conversational Data“-Agent, der auf jede Anfrage eine einzige Definition anwendet, wird unweigerlich inkonsistente Antworten liefern und das Vertrauen der Nutzer untergraben.
Die Lösung besteht nicht in einem weiteren KI-Modell. Es geht um Unternehmensführung.
Die Fachabteilungen sind für die Erstellung und Validierung ihrer Definitionen verantwortlich; die data-Verantwortlichen setzen diese in geregelte Geschäftsregeln um, und die semantische Ebene bewahrt diesen Kontext. Der dialogorientierte Data-Agent wählt daraufhin anhand der Rolle, der Geschäftsfunktion und der Absicht des Benutzers die passende Definition aus. Darüber hinaus weiß er nun, wer die Frage stellt, welchen Kontext der Benutzer hat, und trifft eine Entscheidung darüber, auf welches data-Produkt zurückgegriffen werden soll.
Das Betriebsmodell für Unternehmensintelligenz
“Vernetzen. Organisieren. Aktivieren.” schafft die technologische Grundlage für KI im Unternehmen.
Die operative Umsetzung von KI auf Unternehmensebene erfordert eine weitere Fähigkeit: Verbessern.
Unternehmensintelligenz ist kein statisches Gut. Geschäftsdefinitionen entwickeln sich weiter. Produkte ändern sich. Vorschriften ändern sich. KI-Fähigkeiten verbessern sich. Jede Interaktion schafft neue Möglichkeiten, die Grundlage der Unternehmensintelligenz zu stärken.
Kontinuierliche Verbesserung erfolgt durch einen einfachen Betriebszyklus.
Entdecken Sie
Künstliche Intelligenz sollte genutzt werden, um kontinuierlich Möglichkeiten zur Verbesserung der Unternehmensintelligenz zu erschließen.
Durch Beobachtung metadata, Abfragemuster, die Anwendung von Geschäftsregeln, Beziehungen zwischen den data-Produkten sowie das Verbraucherverhalten – auf dieser Grundlage identifiziert die Plattform Möglichkeiten zur Stärkung der Geschäftslogik und empfiehlt neue KI-fähige data-Produkte, metadata zu verbessern und wiederverwendbare Erkenntnisse domänenübergreifend auszubauen.
Jede Interaktion wird zu einer neuen Lernerfahrung.
Zertifizieren
Die KI entdeckt. Menschen schaffen Vertrauen.
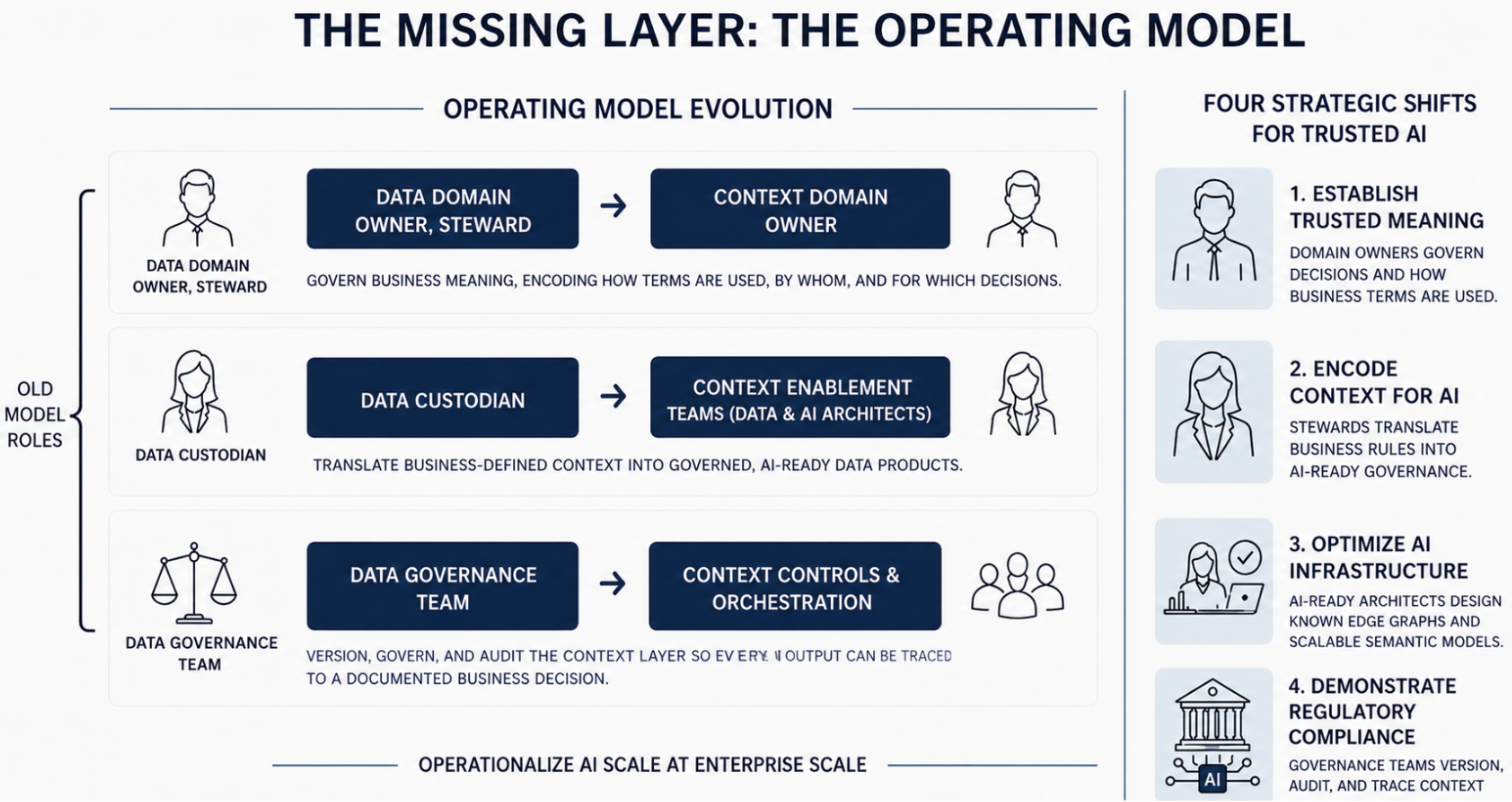
Vertrauenswürdige KI erfordert klare Zuständigkeiten, nicht mehr Governance. Geschäfts- und Technologieteams spielen jeweils eine eigene Rolle dabei, sicherzustellen, dass die KI im richtigen geschäftlichen Kontext eingesetzt wird und sich im Zuge der Weiterentwicklung des Unternehmens kontinuierlich verbessert.
- Inhaltsbereichsverantwortliche die Bedeutung von Geschäftsbegriffen zu regeln, indem festgelegt wird, wie Begriffe verwendet werden, von wem und für welche Entscheidungen.
- Teams für die Kontextaktivierung (Data und KI-Architekten) Geschäftlich definierte Kontexte in regulierte, KI-fähige data-Produkte umsetzen.
- Team für Kontextsteuerung und Orchestrierung die Kontextschicht zu verwalten, zu steuern und zu prüfen, um sicherzustellen, dass jede KI-Ausgabe auf eine dokumentierte geschäftliche Entscheidung zurückgeführt werden kann
Wiederverwendung
Zertifizierte Informationen lassen sich sofort in Analysen, Anwendungen und, AIDA, sowie zugelassene KI-Agenten. Jeder neue Kunde liefert Feedback, das die Grundlage der Unternehmensintelligenz verbessert.
Mit jeder Iteration gewinnt die Unternehmensintelligenz an Zuverlässigkeit, Vollständigkeit und Wert.
Dieses Betriebsmodell erfordert keine neue Organisationsstruktur. Es erweitert den Aufgabenbereich bestehender Funktionen. Gemeinsam bilden Technologie und Menschen ein System der kontinuierlichen Informationsgewinnung.
Starburst bildet die technologische Grundlage. Das Betriebsmodell gewährleistet, dass sich die Unternehmensintelligenz im Zuge der geschäftlichen Entwicklung kontinuierlich weiterentwickelt.
Was könnte ohne das Betriebsmodell schiefgehen?
Ohne ein intelligentes Betriebsmodell fehlt der KI der vertrauenswürdige geschäftliche Kontext, der erforderlich ist, um konsistente und zuverlässige Antworten zu liefern. Stellen Sie sich vor, eine Bank würde KI-Assistenten einsetzen, bevor Geschäftsdefinitionen, Richtlinien und Regeln geregelt und zertifiziert wurden. Wenn Führungskräfte nach der Anzahl der aktiven Kunden fragen, liefern verschiedene KI-Agenten und Dashboards unterschiedliche Antworten.
Das Problem geht weit über inkonsistente Zahlen hinaus. Ohne eine klare Zuständigkeit für den geschäftlichen Kontext selbst kann niemand erklären, welche Definition angewendet wurde, warum sie gewählt wurde oder wer sie als Richtlinie genehmigt hat. Wenn etwas schiefgeht, löst sich die Rechenschaftspflicht in der Aussage “Die KI hat es so gesagt” auf, und das ist keine Antwort, die Führungskräfte, Aufsichtsbehörden oder Kunden akzeptieren werden. Da KI zunehmend in die alltägliche Entscheidungsfindung eingebettet wird, können es sich Unternehmen nicht leisten, auf Intelligenz zurückzugreifen, für die niemand die Verantwortung übernimmt.
Führende Unternehmen erkennen, dass die Herausforderung nicht darin besteht, mehr KI-Agenten zu entwickeln. Vielmehr geht es darum, festzulegen, wer für den geschäftlichen Kontext verantwortlich ist, auf den sich jeder Agent stützt, damit Vertrauen und Verantwortlichkeit entsprechend mitwachsen.
Wie wir bei Artefact dabei vorgehen
Bei Artefact ist die Bewertung als zentraler Arbeitsschwerpunkt in unsere „AI Factory“-Methodik integriert. Jedes Projekt zur Entwicklung eines Agenten umfasst eine Phase der Konzeption eines Bewertungsrahmens, die parallel zur Entwicklung des Agenten verläuft. Wir definieren Bewertungskriterien auf Trajektorienebene, erstellen auf den jeweiligen Anwendungsfall zugeschnittene Szenariobibliotheken und richten eine kontinuierliche Überwachung ein, bevor der Agent in Betrieb genommen wird.
Der Gedanke dahinter ist ganz einfach: Ein Agent, den Sie messen können, ist ein Agent, dem Sie vertrauen, den Sie verbessern und skalieren können. Die Organisationen, mit denen wir zusammenarbeiten und die diesen Ansatz frühzeitig umsetzen, erreichen die Produktionsreife durchweg schneller und genießen dabei ein größeres Vertrauen seitens der Beteiligten.
Führende Köpfe im Bereich der KI entwickeln nicht nur bessere Agenten. Sie Aufbau eines intelligenten Betriebsmodells jetzt, weil sie es als beides betrachten ein unmittelbarer Wachstumsmotor und ein langfristiger Wettbewerbsvorteil.
Eine geregelte Intelligenzebene, deren Eigentum und Wartung klar definierten Verantwortlichen obliegt, beschleunigt jede KI-Initiative auf einmal. Governance ist bereits integriert, sodass Teams diese nicht erst nachträglich einbinden müssen. Die Ebene funktioniert mit jedem Agenten, den ein Team entwickeln möchte, sodass jede neue Initiative auf derselben bewährten Grundlage aufbaut, anstatt diese von Grund auf neu erstellen zu müssen. Und da sich Geschäftsanwender aus einer Quelle bedienen können, der sie vertrauen, müssen sie nicht mehr auf die IT warten, nur um eine Antwort zu erhalten. Insgesamt müssen Teams nicht mehr für jeden neuen Anwendungsfall Definitionen, Regeln und Kontexte neu erfinden, da diese Arbeit bereits von jemand anderem geleistet wurde und dieser auch dafür verantwortlich ist, sie auf dem neuesten Stand zu halten.
Wo sollten Unternehmen ansetzen? Der Weg zu vertrauenswürdiger KI beginnt mit gezielten Anwendungsfällen und nicht mit einer unternehmensweiten Umstellung. Führende Unternehmen ermitteln, in welchen Geschäftsbereichen sich die größten Auswirkungen erzielen lassen, benennen von Anfang an klare Verantwortliche für diese Bereiche und nutzen die daraus gewonnenen Erkenntnisse, um ihr Betriebsmodell im Laufe der Zeit weiterzuentwickeln.
Mit der Weiterentwicklung von KI-Modellen werden Unternehmen, die über zuverlässige Unternehmensdaten und klare Verantwortlichkeiten verfügen, schneller wachsen und sich einen dauerhaften Wettbewerbsvorteil gegenüber jenen verschaffen, die durch fragmentierte data-Strukturen und einen nicht zuordenbaren geschäftlichen Kontext eingeschränkt sind.
Die Vorbereitung der Informationsgewinnung heute ist nicht nur eine Vorbereitung auf die Zukunft der KI. Sie ist ein strategischer Vorteil für morgen, und sie beginnt mit der Entscheidung, wer dafür verantwortlich ist, dass alles richtig läuft.
Wenn Sie erfahren möchten, wie wir anderen Kunden dabei helfen, diese Situation zu meistern, wenden Sie sich bitte an die Teams von Artefact und Starburst:
Artefact: Akhilesh Kale (akhilesh.kale@artefact.com) | Nivetha Aravindan (nivetha.aravindan@artefact.com)
Starburst: Adran Estala (adrian.estala@starburstdata.com) | Christian Velez (christian.velez@starburstdata.com) | Evan Smith (evan.smith@starburstdata.com)