Mit der Weiterentwicklung der artificial intelligence-Modelle verlagert sich der Wettbewerbsvorteil von den Modellen selbst hin zu den Unternehmensdaten, die sie verarbeiten. Konversationsfähige data-Agenten lassen sich häufig nicht über erste Pilotprojekte hinaus skalieren, da sie einen geregelten geschäftlichen Kontext – Definitionen, Richtlinien und institutionelles Wissen – erfordern und nicht nur auf den Abruf von data-Daten beschränkt sind. Ein von Artefact Starburst begegnet dieser Einschränkung durch die Einführung einer „Enterprise Intelligence“-Ebene. Diese Ebene verknüpft fragmentierte Informationen, ordnet sie in zertifizierte data-Produkte ein und macht sie für den agentenbasierten Einsatz nutzbar. Durch die Integration von geschäftlicher Rechenschaftspflicht in die data-Architektur stellt das System sicher, dass KI-Ergebnisse erklärbar und nachvollziehbar sind und auf zertifiziertem Unternehmenswissen basieren.
Lesen Sie diesen vollständigen Artikel von Dr. Stylianos (Stelios) Kampakis unter Die Website „Data Scientist“
Abschnitt 1: Die kontextbezogene Anfälligkeit in KI-Pipelines von Unternehmen
Herkömmliche „Retrieval-Augmented Generation“ (RAG) und metadata-Kataloge basieren auf semantischer Nähe und dem Abgleich von Schlüsselwörtern. Ihnen fehlt die architektonische Fähigkeit, geschäftliche Zuständigkeiten oder Zusammenhänge über komplexe systemische Beziehungen hinweg zu klären. Eine Vektorsuche liefert Textpassagen, die der Suchanfrage eines Nutzers ähneln, kann jedoch nicht feststellen, ob eine bestimmte Finanzkennzahl von der Finanzabteilung genehmigt wurde oder wie unterschiedliche data-Punkte über betriebliche Silos hinweg miteinander verbunden sind.
Dieser Mangel führt zu gravierenden Inkonsistenzen in Unternehmensumgebungen. Wenn ein Dialogagent die Anzahl der “aktiven Kunden” innerhalb eines Finanzinstituts abfragt, stößt er auf widersprüchliche Definitionen. Im Privatkundengeschäft wird ein Kunde als Kontoinhaber definiert; Teams zur Bekämpfung der Geldwäsche (AML) definieren ihn als risikobewertete Person; das Marketing stützt sich auf Verhaltensprofile. Ein probabilistisches Modell, das eine einzige Definition universell anwendet, wird widersprüchliche und ungenaue Antworten liefern. Ohne eine einheitliche Kontextschicht muss jeder neue Chatbot die Geschäftslogik eigenständig von Grund auf neu berechnen, was zu Doppelarbeit und einem Verlust an Vertrauen in das System führt. Die zentrale Schwachstelle ist die Annahme, dass das bloße Abrufen von data-Rohdaten gleichbedeutend mit Business Intelligence ist.
Abschnitt 2: Der unternehmensbezogene Ansatz für Sicherheitsvorkehrungen im Bereich der künstlichen Intelligenz
Um diese Schwachstelle zu mindern, muss die Unternehmensarchitektur die data-Abfrage von der Durchsetzung der Geschäftslogik trennen. Die Enterprise-Intelligence-Ebene dient dabei als Vermittler und verknüpft zertifizierte data-Daten mit geschäftlichen Bedeutungen, Beziehungen und Governance-Regeln. Starburst und Artefact weisen darauf hin, dass eine Ontologie- oder Kontextebene data-Definitionen anhand von Urheberschaft, Verwendungshäufigkeit und Zertifizierungsstatus bewerten kann.
Dieses Konzept schließt die Lücke zwischen der reinen data-Zuordnung und der Validierung zur Laufzeit. Anstatt einen massiven physischen Zentralisierungsaufwand im data-Bereich zu erzwingen, verbindet die Architektur bestehende Betriebssysteme, data-Lakes, semantische Modelle und Business-Intelligence-Tools miteinander. Das System validiert und wendet diese Ressourcen im Rahmen einer geregelten Struktur an. Durch die Einrichtung dieser Intelligenzebene vervielfachen Unternehmen die Effektivität ihrer Modelle, sodass die KI Anfragen anhand verlässlicher Unternehmensdaten bewerten kann, anstatt auf isolierte data-Datenpunkte zurückzugreifen.
Abschnitt 3: Architektonischer Entwurf für Enterprise Intelligence
Eine Produktivimplementierung folgt einem klar definierten Ablauf, um den geschäftlichen Kontext zu strukturieren und zu pflegen:
Verbinden: Das System bündelt die Unternehmenssysteme data und metadata plattformübergreifend. Dadurch werden störende Zentralisierungsprogramme vermieden, sodass die Architektur die bereits im Netzwerk vorhandenen Informationen nutzen kann.
Organisieren: Das vernetzte data-System wird zu KI-fähigen data-Produkten zusammengefasst, die auf Kerngeschäftsbereiche wie Kunden, Produkte, Richtlinien oder Lieferanten ausgerichtet sind. Jedes data-Produkt beinhaltet strukturelle Steuerungsmechanismen und eine explizite geschäftliche Bedeutung.
Aktivieren: Diese geregelten Produkte bilden die gemeinsame Grundlage für Anwendungen, Dashboards und KI-Agenten. Die KI bearbeitet Anfragen anhand zertifizierter Logik, anstatt oberflächliche Vermutungen anzustellen.
Entdecken Sie: Das System überwacht Abfragemuster, metadata und das Verbraucherverhalten, um Möglichkeiten zur Verfeinerung der Logik und zur Abbildung von Beziehungen zu identifizieren.
Zertifizieren und wiederverwenden: Beauftragte Verantwortliche validieren die erkannten Zusammenhänge und schaffen so Vertrauen durch menschliche Einbindung. Nach der Zertifizierung werden die Erkenntnisse unternehmensweit bereitgestellt, was künftige KI-Implementierungen beschleunigt.
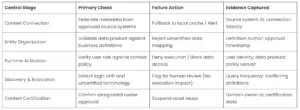
Tabelle 1: Unternehmenssteuerungsoberfläche für ein kontextbezogenes KI-Gate
Abschnitt 4: Betriebsmodell, Steuerung und kontinuierliche Bewertung
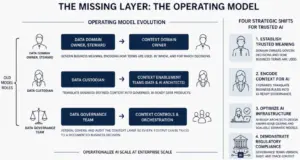
Die technologische Grundlage erfordert ein paralleles Betriebsmodell, um die Genauigkeit zu gewährleisten und einen Kontextverlust zu verhindern. Geschäftsdefinitionen ändern sich aufgrund von Marktbedingungen, Übernahmen oder Änderungen der regulatorischen Rahmenbedingungen. Fehlen in der Intelligenzebene instrumentierte Pipelines und eine aktive Pflege, verschlechtert sich die Qualität des semantischen Graphen.
Um dies zu verhindern, sieht die Architektur eine klare Zuständigkeitsverteilung auf drei verschiedene Teams vor. Die „Context Domain Owners“ definieren die geschäftliche Bedeutung und die Anwendungsregeln. Die „Context Enablement Teams“ entwickeln die KI-fähigen data-Produkte. Die „Context Controls and Orchestration Teams“ überprüfen die Ebene und stellen sicher, dass jede KI-Ausgabe auf eine dokumentierte Richtlinienentscheidung zurückgeführt werden kann.
Artefact integriert die Bewertung mithilfe seiner „AI Factory“-Methodik direkt in die Entwicklung von Agenten. Dies umfasst die Definition von Bewertungskriterien auf Trajektorienebene, den Aufbau von auf den jeweiligen Anwendungsfall zugeschnittenen Szenariobibliotheken sowie die Implementierung einer kontinuierlichen Überwachung vor der Bereitstellung. In diesem Modell verlagert sich die Steuerung in den Laufzeitpfad und kontrolliert die Aktionen des Agenten während der Aufgabenausführung, anstatt lediglich den Lesezugriff vor der Ausführung festzulegen. Wenn ein KI-System eine Ausgabe erzeugt, stützt sich das Unternehmen auf eine geprüfte Steuerungsebene, anstatt die Entscheidung vollständig dem Modell zuzuschreiben.
Abschnitt 5: Schlussfolgerung und Ausblick
Unternehmen, die den Einsatz von dialogorientierter KI ausweiten möchten, müssen sich bewusst sein, dass Modelle allein keinen geschäftlichen Kontext schaffen können. Der architektonische Übergang von probabilistischer Informationsgewinnung zu deterministischer, regulierter Intelligenz ist eine Voraussetzung für den produktiven Einsatz in regulierten Umgebungen.
Das von Artefact und Starburst vorgeschlagene Integrationsmodell bietet einen strukturellen Rahmen für diesen Wandel. Durch die Einführung zertifizierter data-Produkte, die Zuweisung klar definierter Zuständigkeiten für bestimmte Bereiche und die Umsetzung einer kontinuierlichen Laufzeitbewertung können Unternehmen Agenten einsetzen, die überprüfbare und zuverlässige Entscheidungen treffen. Die künftige Skalierung der KI wird von dem Rechenschaftsmodell abhängen, das die Unternehmensintelligenzebene verwaltet und sicherstellt, dass jeder neue Agent eine stabile, zertifizierte Grundlage an institutionellem Wissen übernimmt.
Für weitere Informationen wenden Sie sich bitte an:
- Akhilesh Kale, Partner bei Artefact — akhilesh.kale@artefact.com
- Adrian Estala, Starburst — Anzeigerian.estala@starburstdata.com