Naarmate artificial intelligence-modellen zich verder ontwikkelen, verschuift het concurrentievoordeel van de modellen zelf naar de bedrijfsinformatie die zij verwerken. Conversatiegerichte data-agenten slagen er vaak niet in om verder te schalen dan de eerste proefprojecten, omdat zij een gestructureerde zakelijke context vereisen – definities, beleidsregels en institutionele kennis – in plaats van louter het ophalen van data-gegevens. Een raamwerk ontwikkeld door Artefact Starburst pakt deze beperking aan door een enterprise intelligence-laag te introduceren. Deze laag brengt gefragmenteerde informatie met elkaar in verband, organiseert deze in gecertificeerde data-producten en maakt deze bruikbaar voor agentisch gebruik. Door zakelijke verantwoordingsplicht te integreren met de data-architectuur, zorgt het systeem ervoor dat AI-uitkomsten verklaarbaar en traceerbaar zijn en worden ondersteund door gecertificeerde organisatorische kennis.
Lees dit volledige artikel, geschreven door dr. Stylianos (Stelios) Kampakis, op De website van Data Scientist
Paragraaf 1: De contextuele kwetsbaarheid in AI-pijplijnen binnen ondernemingen
Traditionele Retrieval-Augmented Generation (RAG) en metadata-catalogi werken op basis van semantische nabijheid en trefwoordovereenkomst. Zij beschikken niet over de architecturale capaciteit om zakelijke bevoegdheden vast te stellen of verbanden te leggen binnen complexe systeemrelaties. Een vectorzoekopdracht haalt passages op die lijken op de zoekopdracht van een gebruiker, maar kan niet vaststellen of een specifiek financieel cijfer door de financiële afdeling is goedgekeurd, of hoe uiteenlopende data-punten met elkaar in verband staan over operationele silo’s heen.
Deze tekortkoming leidt tot ernstige inconsistenties in bedrijfsomgevingen. Wanneer een conversatieagent navraag doet naar het aantal “actieve klanten” binnen een financiële instelling, stuit hij op tegenstrijdige definities. In het retailbankwezen wordt een klant gedefinieerd als een rekeninghouder; teams voor de bestrijding van witwassen (AML) definiëren een klant als een persoon die aan een risicobeoordeling is onderworpen; marketing baseert zich op gedragsprofielen. Een probabilistisch model dat één enkele definitie universeel toepast, zal tegenstrijdige en onnauwkeurige antwoorden opleveren. Zonder een uniforme contextlaag moet elke nieuwe agent de bedrijfslogica zelfstandig en vanaf nul berekenen, wat leidt tot dubbel werk en een afname van het vertrouwen in het systeem. De belangrijkste kwetsbaarheid is de veronderstelling dat het opvragen van ruwe data-gegevens gelijkstaat aan bedrijfsinformatie.
Hoofdstuk 2: De ‘Enterprise Context’-benadering van AI-beperkingen
Om deze kwetsbaarheid te beperken, moet de bedrijfsarchitectuur het ophalen van data-gegevens scheiden van de handhaving van de bedrijfslogica. De enterprise intelligence-laag fungeert als deze tussenlaag en combineert gecertificeerde data-gegevens met zakelijke betekenis, relaties en governanceregels. Starburst en Artefact stellen vast dat een ontologie- of contextlaag data-definities kan rangschikken op basis van auteurschap, gebruiksfrequentie en certificeringsstatus.
Dit ontwerp overbrugt de kloof tussen ruwe data-mapping en validatie tijdens de uitvoering. In plaats van een omvangrijke fysieke centralisatie-inspanning op het gebied van data af te dwingen, werkt de architectuur op basis van federatie tussen bestaande operationele systemen, data-data-meren, semantische modellen en business intelligence-tools. Het systeem valideert en past deze middelen toe via een gereguleerde structuur. Door deze intelligentielaag in te voeren, vergroten organisaties de effectiviteit van hun modellen, waardoor de AI verzoeken kan toetsen aan gezaghebbende bedrijfsinformatie in plaats van aan losstaande data-gegevenspunten.
Hoofdstuk 3: Architecturale blauwdruk voor bedrijfsinformatie
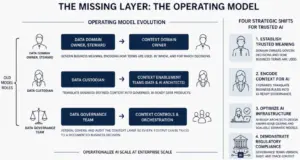
Een productie-implementatie verloopt volgens een duidelijk stappenplan om de bedrijfscontext te structureren en te onderhouden:
Verbinding maken: Het systeem bundelt de systemen data en metadata van de onderneming over bestaande platforms heen. Hierdoor worden verstorende centralisatieprogramma’s vermeden, waardoor de architectuur gebruik kan maken van de intelligentie die reeds binnen het netwerk aanwezig is.
Organiseren: Connected data wordt geïntegreerd in AI-ready data-producten die zijn afgestemd op kernbedrijfsentiteiten, zoals Klant, Product, Beleid of Leverancier. Elk data-product bevat structurele governance en een expliciete zakelijke betekenis.
Activeren: Deze gestandaardiseerde producten vormen de gemeenschappelijke basis voor applicaties, dashboards en AI-agenten. De AI verwerkt verzoeken aan de hand van gecertificeerde logica in plaats van oppervlakkige gissingen te doen.
Ontdek: Het systeem analyseert zoekpatronen, metadata en consumentengedrag om mogelijkheden te identificeren voor het verfijnen van de logica en het in kaart brengen van relaties.
Certificeren en hergebruiken: Aangewezen eigenaren valideren de ontdekte verbanden, waardoor vertrouwen ontstaat waarbij de mens een actieve rol speelt. Zodra de informatie is gecertificeerd, wordt deze binnen de hele organisatie ingezet, waardoor toekomstige AI-implementaties worden versneld.
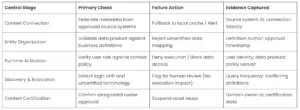
Tabel 1: Bedrijfsbesturingsinterface voor een contextuele AI-gate
Hoofdstuk 4: Bedrijfsmodel, bestuur en voortdurende evaluatie
De technologische basis vereist een parallel bedrijfsmodel om de nauwkeurigheid te waarborgen en contextverlies te voorkomen. Bedrijfsdefinities veranderen als gevolg van marktomstandigheden, overnames of wijzigingen in de regelgeving. Indien de intelligentielaag niet beschikt over geautomatiseerde pijplijnen en actief beheer, verslechtert de semantische grafiek.
Om dit te voorkomen, verdeelt de architectuur de verantwoordelijkheden duidelijk over drie afzonderlijke teams. Contextdomeineigenaren definiëren de zakelijke betekenis en de toepassingsregels. Context-enablementteams bouwen de AI-ready data-producten. Contextcontrole- en orkestratieteams controleren de laag en zorgen ervoor dat elke AI-output terug te voeren is op een gedocumenteerde beleidsbeslissing.
Artefact integreert evaluatie rechtstreeks in de ontwikkeling van agents via de ‘AI Factory’-methodologie. Dit omvat het definiëren van beoordelingscriteria op trajectniveau, het opzetten van scenariobibliotheken die zijn afgestemd op de specifieke use case, en het implementeren van continue monitoring voorafgaand aan de implementatie. Binnen dit model verschuift het beheer naar het uitvoeringstraject, waarbij de acties van de agent tijdens de uitvoering van taken worden gecontroleerd in plaats van uitsluitend de leesrechten vóór de uitvoering vast te stellen. Wanneer een AI-systeem een output produceert, vertrouwt de organisatie op een gecontroleerd besturingsvlak in plaats van de beslissing volledig aan het model toe te schrijven.
Hoofdstuk 5: Conclusie en vooruitzichten
Organisaties die conversatie-AI op grotere schaal willen inzetten, moeten beseffen dat modellen op zichzelf geen zakelijke context kunnen creëren. De architecturale overgang van probabilistische informatieverwerking naar deterministische, gereguleerde intelligentie is een voorwaarde voor implementatie in productieomgevingen binnen gereguleerde sectoren.
Het door Artefact en Starburst voorgestelde integratiemodel biedt een structureel kader voor deze verschuiving. Door gecertificeerde data-producten in te voeren, definitieve domeinverantwoordelijkheid toe te wijzen en continue evaluatie tijdens de uitvoering te implementeren, kunnen ondernemingen agents inzetten die controleerbare, betrouwbare beslissingen opleveren. Toekomstige schaalbaarheid van AI zal afhangen van het verantwoordingsmodel dat de bedrijfsintelligentielaag beheert, waardoor wordt gewaarborgd dat elke nieuwe agent een stabiele, gecertificeerde basis van institutionele kennis erft.
Neem voor meer informatie contact op via:
- Akhilesh Kale, vennoot, Artefact — akhilesh.kale@artefact.com
- Adrian Estala, Starburst — advertentierian.estala@starburstdata.com